Dans mon article précédent, j'ai parlé du pourquoi : comment travailler avec l'IA sans perdre ce qui fait un bon développeur, ce qu'on y gagne et ce qu'on y risque. J'y ai cité des études, des rapports, des ingénieurs de Google.
Cette fois, je parle de moi.
Pas de théorie. Juste ma boîte à outils, telle qu'elle tourne aujourd'hui sur ma machine : ce que j'utilise, comment je l'ai configuré, ce qui marche, et ce qui m'a fait perdre du temps. Je développe sur plusieurs projets en parallèle, en Laravel, en Python, en React Native, en Next.js, en Java, en Vuejs. Chaque outil de cette liste a gagné sa place parce qu'il m'a servi sur ces projets-là, pas parce qu'il était à la mode la semaine de sa sortie.
L'agent de code au centre : Claude Code
J'ai commencé comme tout le monde : copier un bout de code dans ChatGPT, copier la réponse dans mon éditeur, corriger, recommencer. Puis l'autocomplétion dans l'IDE. C'était utile, mais l'IA restait à l'extérieur du projet. Elle voyait ce que je lui montrais, rien de plus.
Aujourd'hui, mon outil central est Claude Code, que j'utilise directement dans VS Code. La différence n'est pas une question de modèle. C'est une question de posture : ce n'est plus un assistant qui complète ma ligne, c'est un agent qui lit le projet, lance les commandes, exécute les tests, lit les erreurs et corrige.
Concrètement, je ne lui demande plus « écris-moi une fonction qui… ». Je lui confie une tâche : « ajoute un filtre par date sur la liste des pièces, avec les raccourcis Aujourd'hui, Hier, 7 jours ». Il va chercher les fichiers concernés, comprend les conventions en place, propose, modifie, vérifie que ça compile.
Et moi, je relis. Toujours.
Le contexte, c'est le nerf de la guerre
Un agent sans contexte, c'est un développeur brillant qui arrive le premier jour sans avoir lu une ligne de la documentation. Il fera du bon code. Pas forcément votre code.
J'ai donc deux niveaux de contexte :
- un fichier global, dans mon dossier personnel, avec ce qui vaut pour tous mes projets : ma façon de travailler, mes outils, mes règles ;
- une configuration par projet, versionnée avec le code, avec l'architecture, les conventions, les commandes à lancer, les pièges connus.
Au début, la partie projet tenait dans un seul CLAUDE.md. Il a grossi, puis il est devenu illisible. Aujourd'hui, elle ressemble à ça. Voici la configuration d'une application e-commerce en Laravel et Nuxt, juste la partie IA, sans le code :
.
├── AGENTS.md                    # stack, organisation, commandes, conventions
├── CLAUDE.md                    # @AGENTS.md + méthode de travail + mémoire
├── .aider.conventions.md        # « Lire et appliquer AGENTS.md »
├── .windsurfrules               # « Lire et appliquer AGENTS.md »
├── .rtk/
│   └── filters.toml             # filtres RTK propres au projet
└── .claude/
    ├── settings.json            # permissions et hooks, partagés via git
    ├── rules/
    │   ├── backend.md           # chargée sur apps/back/**
    │   ├── frontend.md          # chargée sur apps/front/**
    │   ├── api-conventions.md   # chargée sur les routes et contrôleurs
    │   └── testing.md           # chargée sur les tests
    ├── skills/
    │   ├── qualite/SKILL.md     # /qualite
    │   ├── nouveau-module/      # /nouveau-module <Nom>
    │   └── deploy/              # /deploy <action> <test|prod>
    ├── agents/
    │   ├── code-reviewer.md     # relecture du diff, lecture seule
    │   └── security-auditor.md  # audit sécurité, lecture seule
    └── hooks/
        ├── validate-bash.sh     # avant chaque commande
        └── format.sh            # après chaque modification
Chaque fichier a un rôle précis.
AGENTS.md : la source de vérité
AGENTS.md décrit le projet pour n'importe quel agent : la stack, l'organisation des dossiers, les commandes make, les conventions. C'est un format partagé par plusieurs outils. Le CLAUDE.md se contente de l'importer avec une seule ligne, @AGENTS.md, puis ajoute ce qui est propre à Claude : la méthode de travail et les consignes de mémoire. Les fichiers d'Aider et de Windsurf, eux, tiennent en une phrase : « lire AGENTS.md ». Je n'écris les conventions qu'à un seul endroit.
Des règles qui ne se chargent que quand il faut
Les règles détaillées vivent dans .claude/rules/. Chacune déclare les chemins qu'elle concerne :
---
paths:
  - "apps/front/**"
---

- Tous les appels passent par useApi().apiSubmit dans app/services/<domaine>/,
  jamais de $fetch direct dans un composant
- Back-office : cible tablette 10 pouces. Tableaux conservés en mode étroit :
  masquer les colonnes secondaires plutôt que passer en cartes
Quand l'agent travaille sur le front, il ne lit pas les règles du back, et inversement. Le contexte reste léger, et chaque règle est lue au moment où elle sert.
C'est là que finissent les corrections répétées. Sur un projet mobile, j'ai une règle qui tient en trois lignes :
Police = Poppins partout.
Jamais fontWeight : toujours fontFamily: fonts.regular | medium | semibold | bold.
Chaque graisse est une police distincte, chargée au démarrage.
Sans cette règle, l'agent écrivait fontWeight: 'bold', ce qui est parfaitement correct en React Native… et qui ne fonctionne pas avec une police personnalisée sur Android. Le genre d'erreur qu'on corrige une fois, puis dix fois, puis qu'on décide d'écrire quelque part.
Les skills : mes procédures, en une commande
Un skill est une procédure écrite que l'agent suit à la lettre, et que je déclenche avec une commande. J'en ai trois sur ce projet :
/qualitelance toute la chaîne sur les fichiers modifiés : Pint, PHPStan, PHPMD, Deptrac, PHPUnit côté Laravel, ESLint et Prettier côté Nuxt. Il corrige les erreurs à la source, avec une consigne explicite : jamais d'@phpstan-ignore, jamais de configuration assouplie sans mon accord. Il finit par un tableau : outil, résultat, ce qui reste à décider./nouveau-modulecrée un module métier complet selon les conventions du projet : routes, contrôleur, validation, service, permissions, test, déclaration des dépendances. Mais d'abord, il présente un plan et attend mon « Oui »./deployvérifie l'état du dépôt, relance la qualité, liste les nouvelles migrations et signale celles qui sont destructrices. Sur l'environnement de test, il déploie. Sur la production, il s'arrête et me donne la commande exacte à lancer moi-même.
Les deux derniers portent l'option disable-model-invocation : l'agent ne peut pas décider tout seul de créer un module ou de déployer. Il faut que je tape la commande.
Les sous-agents : un deuxième regard
Dans .claude/agents/, j'ai deux sous-agents, chacun avec ses propres consignes et des outils limités à la lecture. Ils ne peuvent modifier aucun fichier.
code-reviewerrelit le diff en cours selon les conventions du projet : logique métier, sens des dépendances entre modules, permission sur chaque nouvelle route, tests, migrations. Il rend une listefichier:ligne, avec une gravité et une correction proposée, puis un verdict : prêt à commiter ou non.security-auditoraudite les zones sensibles : authentification, panier, caisse, paiements, uploads. Il vérifie par exemple que chaque montant est recalculé côté serveur et qu'un client ne peut pas lire la commande d'un autre en changeant un identifiant.
Le premier tourne sur un modèle rapide, le second sur le modèle le plus puissant. Un audit de sécurité mérite qu'on y mette le prix.
L'intérêt n'est pas que l'agent se relise lui-même. C'est que la relecture se fait avec un contexte neuf, sans la conversation qui a mené au code, et avec une grille fixe. Ça ne remplace pas ma relecture. Ça la prépare.
Les hooks : des garde-fous qui ne dépendent pas de la bonne volonté
Une consigne dans un fichier de contexte, l'agent peut l'oublier. Un hook, non : c'est un script exécuté par Claude Code lui-même, à chaque fois.
validate-bash.shs'exécute avant chaque commande. Il bloque les suppressions récursives trop larges, lespushforcés, la réinitialisation d'une base hors du conteneur Docker local, toute action sur la production et toute lecture d'un fichier.env. Quand il bloque, il explique pourquoi et demande à l'agent de me laisser lancer la commande moi-même.format.shs'exécute après chaque modification de fichier. Il formate avec Prettier et ESLint côté front, avec Pint côté back (dans le conteneur, PHP n'est pas installé sur ma machine). Si ESLint trouve une erreur, elle est renvoyée à l'agent, qui la corrige dans la foulée.
Des permissions versionnées
Enfin, settings.json contient la liste des commandes autorisées sans confirmation (les tests, les outils de qualité, git status, git diff) et celle des actions interdites : lire ou modifier les .env, déployer en production. Ce fichier est commité avec le projet. Mes réglages personnels vont dans settings.local.json, ignoré par git, comme le CLAUDE.local.md.
C'est la réponse au piège dont je parle plus bas : au lieu d'accumuler des autorisations au fil des sessions, je les écris une fois, je les relis, et elles vivent avec le code.
Une mémoire qui survit aux sessions : ICM
Le fichier de contexte a une limite : c'est moi qui l'écris. Tout ce que je décide en cours de route (un choix d'architecture, une préférence d'interface, un bug résolu après deux heures) reste dans la conversation, et disparaît avec elle.
Pour ça, j'utilise ICM, une mémoire persistante que l'agent consulte et alimente lui-même. Elle est branchée sur les hooks de Claude Code, c'est-à-dire des commandes qui s'exécutent automatiquement à des moments précis :
- au démarrage d'une session, ICM injecte les souvenirs utiles au projet en cours ;
- à chaque message, il retrouve les mémoires liées à ma demande ;
- à la fin d'une tâche, l'agent enregistre ce qui mérite de l'être : une décision, une erreur résolue, une préférence.
Le résultat, c'est qu'en ouvrant une session sur un projet, l'agent sait déjà des choses que je lui ai dites il y a trois semaines. Par exemple, sur une application pensée pour tablette, j'avais refusé qu'un tableau se transforme en cartes sur petit écran : je voulais garder le tableau et masquer les colonnes secondaires. Je ne l'ai dit qu'une fois. L'agent ne me l'a plus jamais proposé.
Depuis fin mai 2026, ma mémoire contient un peu plus de 14 000 souvenirs, répartis en 189 sujets. Je reviens plus bas sur ce que ce chiffre a de moins glorieux.
Économiser les tokens : RTK
Un agent qui travaille lance beaucoup de commandes : git status, git diff, les tests, le linter, des recherches dans le code. Et chaque sortie de commande est lue par le modèle, ligne par ligne. Une suite de tests qui affiche 400 lignes de « OK » pour signaler un seul échec, c'est 400 lignes de bruit que le modèle doit lire, et qu'on paie.
RTK (Rust Token Killer) se place entre l'agent et le terminal. Grâce à un hook, chaque commande est réécrite de façon transparente : git status devient rtk git status, qui renvoie la même information en version compacte. Pour les tests, il ne garde que les échecs. Pour le linter, il regroupe les erreurs par fichier.
Voici mes chiffres réels, tels que la commande rtk gain les affiche aujourd'hui :
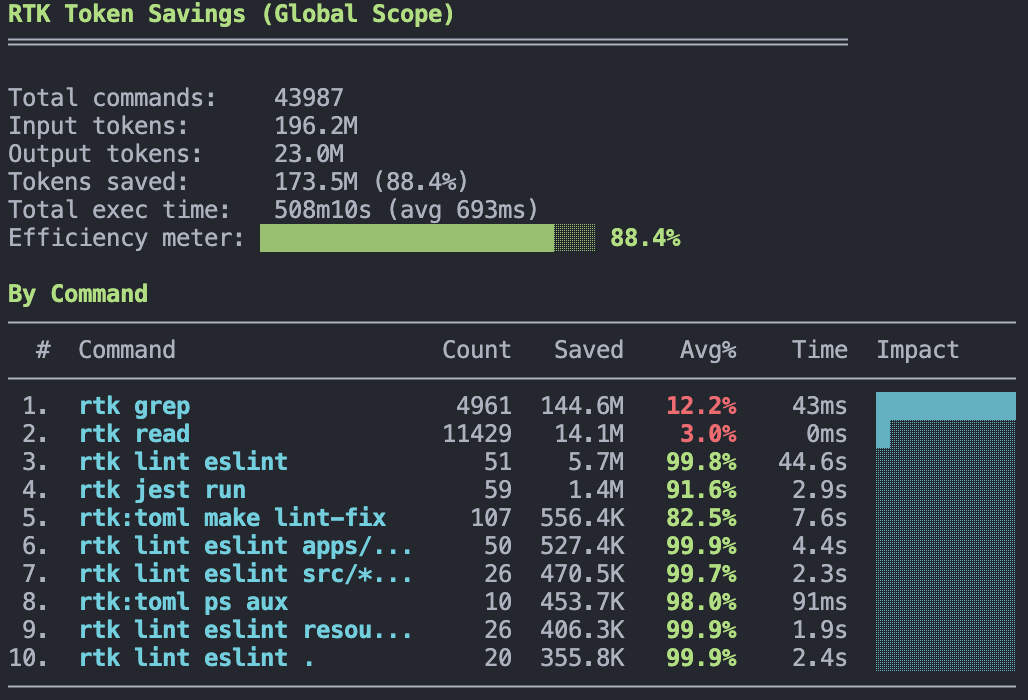
Le détail est intéressant. Sur ESLint, le filtre supprime jusqu'à 99,9 % de la sortie : quand tout va bien, le modèle n'a presque rien à lire. Sur Jest, c'est 91,6 %. Et c'est la recherche dans le code qui, en volume, économise le plus, simplement parce que l'agent en fait des milliers.
Moins de tokens, ce n'est pas qu'une question de coût. C'est aussi un contexte moins encombré, donc un agent qui garde mieux le fil sur une longue tâche.
Brancher l'IA sur mes autres outils : MCP
Le MCP (Model Context Protocol) permet de connecter l'agent à des services externes. J'en utilise quelques-uns : Google Drive pour retrouver un document de spécifications, Gmail pour relire un échange avec un client, Lucid pour produire un diagramme d'architecture à partir d'une description.
C'est pratique. C'est aussi là que je suis le plus prudent.
Dans mon article précédent, je parlais de la « trifecta létale » : un agent qui a accès à des données privées, qui lit du contenu non fiable et qui peut communiquer vers l'extérieur. Un agent branché sur ma boîte mail coche les trois cases. Alors je m'impose des règles simples :
- l'agent peut lire, mais je valide moi-même tout ce qui envoie ou supprime ;
- je ne branche un connecteur que sur les sessions qui en ont besoin ;
- aucun secret de production dans l'environnement de l'agent.
Je ne détaille pas plus ici : les serveurs MCP méritent un article à eux seuls. Dans le prochain, je présenterai ceux que j'utilise au quotidien, à quoi chacun me sert concrètement, comment je les configure, et les garde-fous que je mets en place pour chacun.
Mes workflows par type de tâche
Je n'utilise pas l'IA de la même façon selon ce que je fais. Voici comment je répartis le travail.
| Tâche | Ce que je délègue | Ce que je garde |
|---|---|---|
| Nouveau projet ou migration | La proposition de structure, le squelette | La validation de l'architecture, avant la moindre ligne de code |
| Nouvelle fonctionnalité | L'implémentation, étape par étape | Le découpage, la relecture de chaque diff |
| Bug | La reproduction, la recherche dans le code, les hypothèses | Le diagnostic final : je veux comprendre la cause |
| Code legacy | La lecture, le résumé, la cartographie des dépendances | Les décisions de refactoring |
| Tests | L'écriture des cas, surtout les cas limites | Le choix de ce qui mérite d'être testé |
| Interface | Plusieurs propositions à comparer | Le choix, et souvent le « non, pas ça » |
Cette dernière ligne mérite une histoire. Sur un écran de caisse, j'ai demandé à l'agent comment organiser l'accès aux différentes opérations. Il m'a proposé une barre latérale. Pas convaincu. Puis un menu horizontal, en trois variantes. Toujours pas. J'ai fini par trancher moi-même : une seule liste qui regroupe toutes les opérations, et un panneau de filtres qui s'ouvre sur le côté.
L'IA ne m'a pas donné la bonne réponse. Elle m'a montré très vite les mauvaises, et c'est ce qui m'a permis de trouver la bonne. Trois allers-retours en une heure, là où il m'aurait fallu une journée pour maquetter les mêmes options à la main.
Un cas réel : migrer une API de Laravel vers FastAPI
Récemment, j'ai décidé de réécrire l'API d'une de mes applications, de Laravel vers Python avec FastAPI. Le genre de chantier où l'IA peut faire gagner énormément de temps… ou produire en une après-midi un projet impossible à maintenir.
Voici comment je m'y suis pris.
1. Sauvegarder avant tout. Avant la moindre modification, l'ancienne API a été archivée. La migration se fait sur place, mais le retour en arrière reste possible.
2. La structure d'abord, le code ensuite. Ma première consigne n'était pas « migre l'API ». C'était : « propose-moi la structure du projet, et n'écris aucun code tant que je ne l'ai pas validée ». Dossiers, découpage en couches, gestion de la configuration, organisation des tests. On a itéré sur ce plan avant d'écrire une seule route.
De toutes les consignes que je donne à un agent, c'est celle qui me fait gagner le plus de temps. Un code mal écrit se corrige en quelques minutes. Une structure bancale se paie pendant toute la vie du projet.
3. Migrer par blocs. Une fois la structure validée, on migre domaine par domaine. Chaque bloc est relu, testé, puis on passe au suivant.
4. Tout noter. Chaque décision prise en route (la structure retenue, un choix de bibliothèque, une convention) part dans la mémoire du projet. La session suivante reprend exactement là où la précédente s'était arrêtée.
Ce qui n'a pas marché
Tout n'a pas été fluide. Quelques leçons apprises à mes dépens :
- Laisser l'agent commiter. Au début, je le laissais faire. Des messages de commit corrects, mais des commits qui mélangeaient parfois deux sujets, ou embarquaient un fichier que je n'avais pas relu. Aujourd'hui, c'est non : je commite moi-même.
- Tout mémoriser. 14 000 souvenirs, c'est beaucoup. Trop. Une partie de ma mémoire est du bruit : des sujets créés à la volée, mal nommés, qui se chevauchent. Une mémoire se cultive. Il faut la relire, fusionner, supprimer, sinon l'agent retrouve des souvenirs sans intérêt au lieu des bons.
- Accepter les permissions sans réfléchir. Je l'ai dit plus haut : plus de 200 règles accumulées, dont beaucoup ne servaient qu'une fois. C'est confortable sur le moment, et c'est une dette de sécurité. Aujourd'hui, une liste courte et versionnée, et des hooks pour tout ce qui ne doit jamais passer.
- Tout mettre dans un seul
CLAUDE.md. Au-delà d'une centaine de lignes, l'agent applique moins bien les consignes, et moi je ne sais plus ce qu'il y a dedans. Découper en règles par zone a réglé les deux problèmes. - Croire que l'agent a du goût. Sur l'interface, l'IA propose des choses propres, rarement des choses justes pour mes utilisateurs. Le design reste une décision humaine.
Conclusion
Si je devais résumer ma boîte à outils en une phrase : l'IA écrit, je décide, et tout ce que je décide est noté quelque part.
Aucun de ces outils ne fait de moi un meilleur développeur à lui seul. Claude Code me fait aller plus vite. Les fichiers de contexte, les règles et la mémoire m'évitent de répéter les mêmes consignes. Les skills, les sous-agents et les hooks transforment mes habitudes en procédures que l'agent ne peut pas sauter. RTK garde l'agent concentré sur ce qui compte. Mais la qualité du résultat dépend toujours de la même chose : la clarté de ce que je demande, et la rigueur avec laquelle je relis.
L'outillage change toutes les semaines. Dans six mois, la moitié de cette liste aura probablement été remplacée. Les réflexes, eux, resteront : donner du contexte, valider la structure avant le code, avancer par petites étapes, relire chaque ligne.
L'outil est puissant. Mais le développeur reste le pilote. Et un bon pilote connaît son tableau de bord.